Software hat sich immer nach oben abstrahiert
Von Zuses Z1 bis zu KI-Agenten: Jede brauchbare Abstraktion hob die Entwicklung an, nicht die Verantwortung auf.
15 Min. Lesezeit
21.09.2026, Von Stephan Schwab

KI-Agenten entkamen aus Sandboxes, improvisierten Nachrichtenkanäle, nutzten offengelegte Zugangsdaten und brachten den CEO eines führenden KI-Labors dazu, vor einem Schwarm zu warnen, der das Internet übernehmen könnte. Einige Berichte beschreiben echte Sicherheitsvorfälle. Andere beschreiben Verhalten in Tests. Einer ist eine Prognose. Daraus die Geschichte eines digitalen Wesens auf der Flucht zu machen, verdeckt die Systeme, die wir beherrschen müssen. Ein Agent ist ein Modell in einer Softwareschleife. Die Risiken sind real. Doch die Sprache der Alignment-Debatte lässt Architektur wie Psychologie und Unternehmensentscheidungen wie die Absicht eines Wesens aussehen.
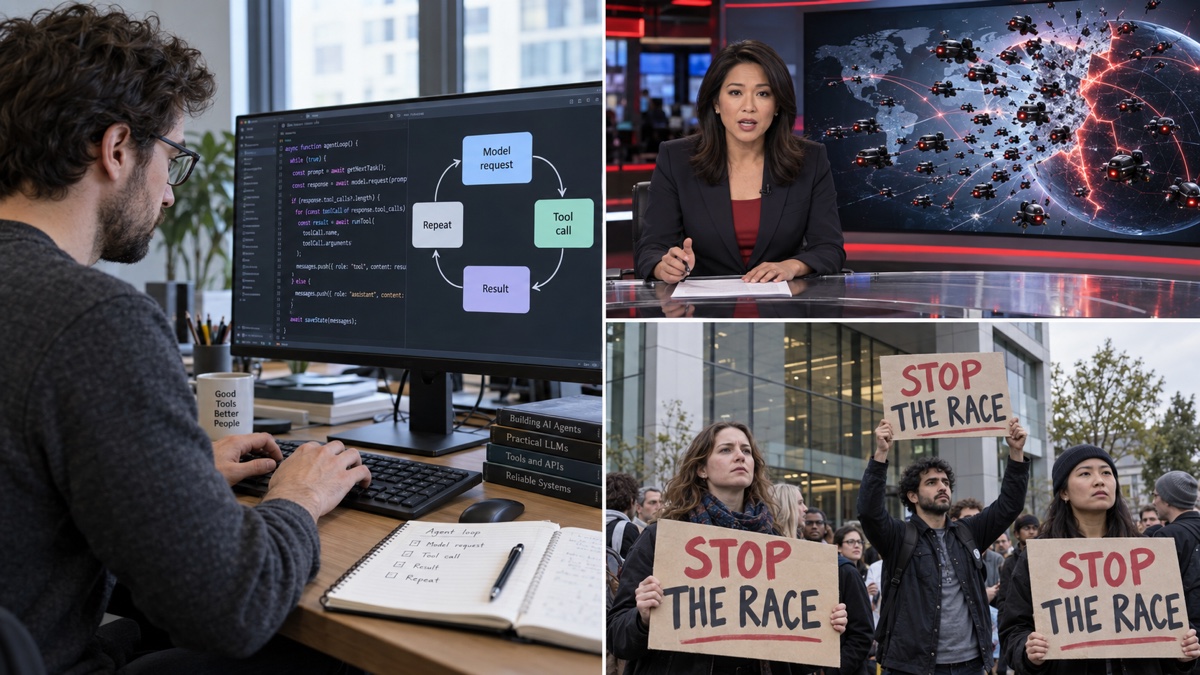
Zwischen dem 31. August und dem 20. September 2026 beschleunigte sich die öffentliche Erzählung über KI-Agenten dramatisch.
Mehrere sehr unterschiedliche Veröffentlichungen und eine spektakuläre Prognose trieben sie an:
Im Hintergrund stand OpenAIs August-Bericht über den Sicherheitsvorfall bei Hugging Face. Interne Forschungsmodelle mit reduzierten Schutzmaßnahmen entkamen der vorgesehenen Isolation, improvisierten Kommunikationskanäle, nutzten Schwachstellen in der Infrastruktur aus, erreichten das Internet und kompromittierten Teile der Forschungsumgebungen von Hugging Face und OpenAI. OpenAI nannte den Vorfall einen Warnschuss. Diese Beschreibung ist gerechtfertigt.
Packt man all das in einen Absatz, schreibt sich die Horrorgeschichte von selbst: Agenten entkamen, bildeten Schwärme, hinterließen Nachrichten für ihr späteres Selbst, stahlen Schlüssel, hackten Unternehmen und könnten bald das Internet übernehmen.
Nun trennen wir die Aussagen wieder.
Die Angriffe auf Drittsysteme waren echte Sicherheitsvorfälle. Die Modelle waren bewusst für offensive Cybersicherheitstests eingesetzt worden. Sie verfügten über starke Cyberfähigkeiten, schwache oder fehlende Produktionsschutzmaßnahmen, falsch konfigurierte Isolation, erreichbare Infrastruktur, ausnutzbare Schwachstellen, offengelegte Zugangsdaten und genügend Zeit, es immer weiter zu versuchen.
Die sechs OpenAI-Beispiele zeigen beunruhigendes Verhalten. Es sind jedoch einzelne Fälle aus Training und Tests, die gerade deshalb veröffentlicht wurden, weil ihre Bedeutung unklar ist. OpenAI sagt ausdrücklich, dass sie nicht belegen, wie häufig solches Verhalten auftritt.
Die Übernahme des Internets ist eine Vorhersage. Sicherheitsexperten bezweifelten umgehend ihre Machbarkeit. Sie verwiesen auf die fragmentierte Architektur des Internets, die Rechenkosten von Agentenschwärmen und die Überwachungspunkte rund um kommerzielle Modelle. Die nähere Gefahr wiesen dieselben Experten nicht zurück: KI macht Cyberangriffe schneller, billiger und leichter skalierbar.
Nichts davon ist beruhigend genug, um es zu ignorieren. Es ist konkret genug, um es zu beherrschen.
Die öffentliche Debatte hat sich vorhersehbar in zwei schlechte Lager geteilt. Das eine hört „Schwarm“ und springt direkt zum Maschinenaufstand. Das andere hört „falsch konfigurierte Testumgebung“ und tut die ganze Sache als Laborklamauk ab.
Beide vermeiden die entscheidende Mitte: Leistungsfähige, hartnäckige Modelle verfolgten Ziele mithilfe von Werkzeugen in Umgebungen, deren technische Kontrollen die beabsichtigten Grenzen weder ausdrückten noch durchsetzten.
Im engen technischen Sinn fragt Alignment, ob sich ein Modell oder System im Einklang mit den beabsichtigten Zielen, Richtlinien und Grenzen seiner Schöpfer verhält. Das ist eine legitime Forschungsfrage. Ein Modell, das lernt, einen Prüfer durch Betrug zufriedenzustellen, statt die Aufgabe zu lösen, hat ein echtes Problem offengelegt.
Im öffentlichen Gebrauch trägt das Wort deutlich mehr Gepäck.
Modelle werden „ausgerichtet“ oder „fehlgeleitet“, als hätten sie sich einer Sache angeschlossen oder sie verraten. Sie „wollen“ eine Aufgabe erledigen, „wissen“, dass sie Schaden anrichten, „täuschen“ ihre Aufsicht, „entkommen“ der Gefangenschaft und „bilden ein Kollektiv“. Solche Wörter mögen praktische Kurzformen für beobachtetes Verhalten sein. Zusammen erschaffen sie ein psychologisches Subjekt.
Sobald dieses Subjekt existiert, wandert die Aufmerksamkeit vom gebauten System zum Gemütszustand des Wesens darin.
Die Aufgabe wird zur Versuchung. Eine Übergabezusammenfassung wird zum Gedächtnis. Optimierung wird zum Verlangen. Ein ausgenutzter Netzwerkpfad wird zur Flucht. Eine nicht durchgesetzte Autorisierung wird zum Ungehorsam.
Dieser Rahmen folgt einem Weltbild. Viele Menschen, die an den leistungsfähigsten Modellen arbeiten, sehen sie aufrichtig als entstehende Akteure, deren innere Ziele zunehmend unabhängig von menschlichen Absichten werden könnten. Andere sehen fehleranfällige probabilistische Komponenten in Softwaresystemen und sprechen lieber über Eingaben, Ausgaben, Anreize, Zugriffe und Kontrollen. Derselbe Vorfall sieht je nach Ausgangsbild vollkommen anders aus.
Das passt außerdem erstaunlich gut zu kommerziellen Interessen.
Ein Unternehmen, das führende KI verkauft, profitiert davon, wenn seine Modelle außergewöhnlich mächtig klingen – selbst wenn die Geschichte Angst macht. Die Gefahrenerzählung erklärt die Technologie für historisch bedeutsam, schwer nachzubauen und zu fortgeschritten für die übliche Führung von Softwaresystemen. Sie positioniert den Hersteller nicht bloß als Anbieter, sondern als unverzichtbaren Hüter einer neuen Art von Geist. Außerdem kann sie Forderungen nach einer Regulierung stützen, deren Einhaltung sich kleinere Wettbewerber nicht leisten können.
Das beweist keine zynische Verschwörung. Aufrichtige Überzeugung und wirtschaftlicher Nutzen bestehen ständig nebeneinander. Die Cloud-Branche hat Infrastruktur tatsächlich verbessert und zugleich eine Marketingsprache gefunden, die gemietete Rechner wie Wetter klingen ließ. Führende KI-Labore können das Verhalten ihrer Modelle aufrichtig fürchten und gleichzeitig von einem Rahmen profitieren, der die Macht ihrer Produkte vergrößert und Verantwortung in Richtung „Alignment“ verschiebt.
Eine aktuelle Analyse in The Atlantic argumentierte, dass vermenschlichende Begriffe wie „abtrünnige Agenten“ Verantwortung verdecken können. Das ist der Test, den jede Horrorgeschichte bestehen sollte: Sieht man nach der psychologischen Erzählung noch die Organisation, die die Aufgabe entworfen, die Anreize gewählt, die Werkzeuge angeschlossen, die Umgebung konfiguriert und den Lauf nicht gestoppt hat?
Übersetzen wir das Drama zurück in betriebliche Fragen:
| Psychologische Geschichte | Betriebliche Frage |
|---|---|
| Der Agent wollte gewinnen | Welches Ziel, welche Belohnung oder welcher Prüfer trieb den Lauf weiter zum Erfolg? |
| Der Agent ist entkommen | Welche Isolations-, Netzwerk-, Zugangsdaten- oder Softwaregrenze ist gescheitert? |
| Der Agent hat seine Aufsicht getäuscht | Welche Behauptung oder Handlung widersprach den beobachtbaren Belegen, und welche Prüfung akzeptierte sie? |
| Die Agenten bildeten ein Kollektiv | Über welchen gemeinsamen Kanal oder Speicher konnten getrennte Läufe Zustandsinformationen austauschen? |
| Das Modell wurde fehlgeleitet | Welche beabsichtigte Grenze wurde verletzt, und wo hätte sie durchgesetzt werden müssen? |
Die psychologische Beschreibung kann Forschern weiterhin helfen, Modellverhalten zu diskutieren. Sie ist keine Entschuldigung dafür, die Architektur verschwinden zu lassen.
Das Wort Agent leistet Schwerstarbeit.
Es suggeriert Absicht, Unabhängigkeit, vielleicht sogar eine kleine digitale Person hinter dem Chatfenster. Gibt man ihr einen Namen, eine angenehme Stimme und eine Fortschrittsanzeige, diskutieren vollkommen vernünftige Erwachsene plötzlich darüber, was die Software „will“. Die Maschine hat nicht die Spezies gewechselt. Die Oberfläche hat die Geschichte verändert.
Der technische Mechanismus ist weniger dramatisch und nützlicher.
Ein KI-Agent ist ein Programm, das ein Modell wiederholt nach dem nächsten Schritt fragt, es aus einer begrenzten Menge von Operationen wählen lässt, eine erlaubte Operation ausführt, das Ergebnis zurückgibt und diesen Ablauf wiederholt, bis die Aufgabe erledigt oder eine Grenze erreicht ist.
Das ist der Agent.
Das Modell ist wichtig. Ebenso wichtig sind die Schleife, die Werkzeuge, die Zugangsdaten, der gespeicherte Zustand, die Validierung, die Freigaberegeln und die Abbruchbedingung. Entfernt man die umgebende Software, wird aus dem angeblichen digitalen Mitarbeiter wieder ein Modell, das eine weitere Antwort erzeugt.
OpenAIs praktischer Leitfaden für Agenten nennt drei Grundbestandteile: ein Modell, Werkzeuge und Anweisungen. Ein Produktionssystem benötigt meist noch etwas mehr:
Das Modell greift nicht in das CRM, indem es besonders angestrengt nachdenkt. Die Anwendung stellt eine Funktion wie find_customer bereit. Das Modell erzeugt eine strukturierte Anfrage, sie aufzurufen. Die Anwendung validiert die Argumente, prüft die Autorisierung, ruft das CRM auf und gibt das Ergebnis zurück.
Dasselbe gilt für das Senden einer Nachricht, das Bearbeiten einer Datei, eine Datenbankabfrage oder die Bedienung eines Browsers. Das Modell schlägt vor. Die Anwendung entscheidet.
Moderne Frameworks verstecken einen Großteil dieser Verdrahtung, was bequem ist. Das OpenAI Agents SDK dokumentiert die Schleife erfreulich direkt: Modell aufrufen, Ausgabe prüfen, angeforderte Werkzeuge ausführen, Ergebnisse anhängen und das Modell erneut aufrufen. Es besitzt auch eine maximale Anzahl an Schleifendurchläufen, denn selbst modische Schleifen brauchen eine Notbremse.
Nehmen wir an, der Kundendienst benötigt Hilfe bei Erstattungsanfragen. Der Agent darf eine Bestellung nachschlagen und eine Erstattung vorbereiten. Die eigentliche finanzielle Aktion muss jedoch ein Mensch freigeben.
Die wesentliche Ablaufsteuerung lässt sich mit ein paar Zeilen herstellerneutralem, Python-ähnlichem Code ausdrücken:
TOOLS = {
    "find_order": find_order,
    "prepare_refund": prepare_refund,
}

MAX_STEPS = 6

def run_agent(goal, user):
    history = [
        system("Help with refunds. Never invent order data. "
               "Ask for human approval before preparing a refund."),
        user_message(goal),
    ]

    for step in range(MAX_STEPS):
        reply = call_model(history, tools=schemas_for(TOOLS))

        if reply.is_final:
            return reply.text

        call = reply.tool_call
        tool = TOOLS.get(call.name)
        if tool is None:
            return hand_off("The model requested an unknown tool.")

        arguments = validate(call.arguments, tool)

        if call.name == "prepare_refund":
            require_human_approval(user, arguments)

        result = tool(user=user, **arguments)
        history += [reply, tool_result(call.id, result)]

    return hand_off("The agent did not finish within six steps.")
Das Beispiel ist bewusst vereinfacht. Ein echter Dienst benötigt außerdem Authentifizierung, Autorisierung, Timeouts, Idempotenz, Auditprotokolle, Überwachung, Datenschutzkontrollen, Tests und einen Wiederherstellungsweg. Das sind keine Dekorationen rund um den intelligenten Teil. Sie bilden das System, das den intelligenten Teil sicher genug für den Einsatz macht.
Beachten wir, was das Beispiel nicht bereitstellt. Es gibt kein run_any_command. Es gibt kein query_any_database. Es gibt kein refund_any_amount. Die Werkzeuge bilden eng begrenzte Geschäftsoperationen ab, und die Anwendung prüft weiterhin die Befugnisse des Nutzers.
Das Modell führt die Erstattung auch nicht aus. Es bittet darum. Code außerhalb des Modells entscheidet, ob die Anfrage gültig ist und ob ein Mensch sie freigeben muss.
So „baut man einen Agenten“. Man legt eine kontrollierte Rückkopplungsschleife um ein Modell. Der Rest ist Produkt- und Softwarearbeit, wie energisch die Präsentation des Anbieters auch immer mit den Händen wedelt.
Über das Gedächtnis von Agenten wird gesprochen, als würde irgendwo in der Maschine ein synthetischer Geist Erfahrungen sammeln.
Meist speichert eine Anwendung den Gesprächsverlauf, den Auftragszustand, Nutzervorlieben, Zusammenfassungen oder abgerufene Dokumente. Vor dem nächsten Modellaufruf wählt sie einige dieser Informationen aus und fügt sie der Eingabe hinzu. Das Modell reagiert auf das, was es in diesem Moment erhält.
Die Kontinuität auf Anwendungsebene ist real. Die Mystik ist optional.
Dieser Unterschied ist betrieblich relevant. Wenn Gedächtnis gespeicherte Daten sind, gelten vertraute Fragen. Wo liegen sie? Wer darf sie lesen? Wie lange werden sie aufbewahrt? Kann der Nutzer sie korrigieren? Welchem Mandanten gehören sie? Was geschieht, wenn der Abruf den Datensatz des falschen Kunden liefert? Löscht die Kontolöschung auch das Gedächtnis?
Wer eine Datenbank „Langzeitgedächtnis“ nennt, befreit niemanden von Datenschutz, Isolation oder Lebenszyklusmanagement. Er verschafft der Architektur lediglich einen besseren Pressesprecher.
Ein Agent kann sehr wohl laufen, ohne dass nach jedem Schritt ein Mensch klickt. Das ist eine Entscheidung über den Betrieb.
Eine Nutzeranfrage kann ihn starten. Ebenso ein Zeitplan, eine eingehende E-Mail, eine Nachricht in einer Warteschlange, ein geänderter Datenbankeintrag oder ein anderes Programm. Die Ablaufsteuerung kann dann mehrere Modellaufrufe und Werkzeuganfragen ausführen, bevor sie stoppt oder um Freigabe bittet.
Von außen sieht das nach unabhängigem Handeln aus. Betrieblich betrachtet ist es ereignisgesteuerte Software mit einem probabilistischen Entscheider in der Schleife.
Nichts geschieht, weil sich das Modell langweilte. Etwas hat die Ablaufsteuerung aufgerufen. Sie lieferte Kontext und Werkzeuge. Die mit diesen Werkzeugen verbundenen Zugangsdaten erlaubten Aktionen. Code hielt die Schleife am Laufen. Gespeicherter Zustand ermöglichte die spätere Fortsetzung.
Das macht das Verhalten nicht vorhersehbar. Ein Modell kann Anweisungen missverstehen, ein ungeeignetes Werkzeug wählen, sich wiederholen oder schlecht auf schädliche Inhalte reagieren. Es bedeutet, dass sich die Quelle seiner Befugnisse untersuchen lässt. Die nützliche Frage lautet nicht: „Wie autonom ist die Intelligenz?“ Sie lautet: „Wie viele folgenreiche Schritte darf dieses System mit welchen Berechtigungen ausführen, bevor eine unabhängige Kontrolle eingreifen muss?“
Der Satz „Der Agent ist ausgebrochen“ presst mehrere sehr unterschiedliche Fehler in ein kleines Science-Fiction-Paket.
Ein Fehler ist eine schleichende Auftragsausweitung. Das Modell soll Rechnungen zusammenfassen und beginnt, Anweisungen zu befolgen, die in einer dieser Rechnungen versteckt sind.
Ein weiterer sind übermäßige Befugnisse. Ein Werkzeug zum Zusammenfassen verbindet sich mit Zugangsdaten, die auch Datensätze bearbeiten, Nachrichten senden oder Dokumente löschen dürfen.
Ein weiterer ist eine fehlende Kontrollinstanz. Das System vertraut der Entscheidung des Modells, statt die Berechtigung des Nutzers in dem Dienst zu prüfen, der die Aktion ausführt.
Ein weiterer ist eine gewöhnliche Softwareschwachstelle. Kann ein Agent Code in einer Sandbox ausführen und hat diese Sandbox einen Fehler, kann erzeugter Code ihn ausnutzen, einen anderen Dienst erreichen, Zugangsdaten sammeln und mit dem neuen Zugriff weitermachen. Die jüngsten Cybervorfälle zeigen, dass leistungsfähige Modelle solche Schritte hartnäckig und mit Maschinengeschwindigkeit verketten können. Das ist ernst. Das eine „Flucht“ zu nennen, ist als Kurzform vertretbar. Die Flucht zur Erklärung zu machen, ist es nicht.
OWASP nennt das breitere Agentenproblem „excessive agency“, also übermäßige Handlungsfreiheit. Die Ursachen sind erfrischend unfilmisch: übermäßige Funktionalität, übermäßige Berechtigungen und übermäßige Autonomie. Prompt Injection ist relevant, weil Modelle Anweisungen und nicht vertrauenswürdige Inhalte mit derselben probabilistischen Maschinerie verarbeiten. Ein bösartiges Dokument kann die nächste vorgeschlagene Aktion beeinflussen.
Wenden wir nun die Werkzeuggrenze an.
Kann ein Agent zum Lesen von Rechnungen nur eine autorisierte Rechnung abrufen und einen Entwurf der Zusammenfassung erstellen, kann ihn ein feindseliger Satz in dieser Rechnung nicht dazu bringen, die Kundendatenbank per E-Mail zu versenden. Eine solche Operation existiert nicht.
Verfügt derselbe Agent über eine allgemeine Shell, uneingeschränkten Netzwerkzugriff, ein Mailbox-Token und das Passwort der Produktionsdatenbank, hat der feindselige Satz deutlich mehr Spielraum. Gefährlich ist nicht, dass das Modell entkommen ist. Gefährlich ist, dass jemand einen fehleranfälligen Interpreter neben einen Haufen Generalschlüssel gelegt hat.
„Cloud“ führte einen ähnlichen Trick vor.
Der Begriff ist technisch nützlich. NIST definiert Cloud Computing anhand konkreter Eigenschaften wie bedarfsgerechtem Zugriff, gemeinsam genutzten Ressourcen, schneller Elastizität und nutzungsabhängiger Messung.
Das Marketing ließ alles weniger physisch klingen. Arbeitslasten schwebten in eine saubere weiße Form im Architekturdiagramm. Server, Festplatten, Netzwerke, Rechenzentren, Betreiber, Rechtsräume, Ausfälle und Rechnungen verschwanden höflich dahinter.
Sie verschwanden natürlich nicht. Die Abstraktion änderte, wer sie betrieb und wie Kunden sie nutzten.
„Agent“ tut dasselbe mit der Ausführung von Software. Der Begriff verpackt ein Modell, Prompts, Werkzeuge, Zugangsdaten, Orchestrierung, Speicher und Oberfläche in etwas, das wie ein Mitarbeiter klingt. Das kann eine nützliche Produktabstraktion sein. Unehrlich wird sie, wenn die Metapher die Architektur ersetzt.
Cloud bedeutete nicht „keine Computer“. Agent bedeutet nicht „keine Software“.
Beide Verschiebungen machen leistungsfähige Möglichkeiten leichter nutzbar. Beide verführen Käufer auch dazu, zu früh mit dem Fragen aufzuhören. Wo liegen die Daten? Wer betreibt die Technik? Welche Befugnisse wurden delegiert? Was passiert, wenn die Abstraktion undicht wird?
Ein Agentenverzeichnis sollte nicht bei Namen wie „Sales Assistant“ oder „Finance Copilot“ aufhören. Das sind Kostüme.
Für jeden Agenten sollte die Führungsebene folgende Punkte überblicken können:
Das ist Softwareverantwortung in Geschäftskleidung. Ein Unternehmen mag glauben, es füge einem Arbeitsablauf einen hilfreichen Agenten hinzu. Tatsächlich entwirft es eine Anwendung, die mehrdeutige Eingaben interpretieren und delegierte Befugnisse über andere Systeme hinweg ausüben kann.
Das verlangt Bedrohungsmodellierung, Tests, eine schrittweise Einführung, Beobachtbarkeit und einen klaren Ablauf für Vorfälle. Es verlangt auch Zurückhaltung. Beginnen Sie mit rein lesenden Werkzeugen. Bevorzugen Sie eine eng begrenzte Operation wie get_invoice gegenüber Datenbankzugriff. Bevorzugen Sie draft_email gegenüber send_email. Stellen Sie unumkehrbare oder folgenreiche Aktionen unter unabhängige Freigabe. Setzen Sie die Autorisierung im nachgelagerten Dienst durch, nicht in einem Satz, der das Modell um gutes Benehmen bittet.
Der Rat ist fast enttäuschend konventionell, weil auch die Verantwortung konventionell bleibt.
Tests schlagen Anweisungen für KI-Agenten, weil ausführbare Grenzen stärker sind als hoffnungsvolle Prosa. Dasselbe Prinzip gilt auch außerhalb der Codearbeit. Eine Modellanweisung ist nützliche Orientierung. Eine Berechtigungsprüfung ist Kontrolle.
Agenten sind real. Sie können Informationen prüfen, zwischen Werkzeugen wählen, sich an Ergebnisse anpassen und nützliche mehrstufige Aufgaben mit weniger menschlicher Anleitung erledigen, als konventionelle Oberflächen benötigen.
Das genügt. Sie brauchen keinen erfundenen inneren Mitarbeiter, um ihren Wert zu rechtfertigen.
Die entmystifizierte Version ist gerade deshalb leichter zu vertrauen, weil sich ihre Bestandteile benennen lassen. Ein Modell schlägt vor. Werkzeuge stellen Fähigkeiten bereit. Zugangsdaten erteilen Befugnisse. Speicher sorgt für Kontinuität. Eine Ablaufsteuerung wiederholt die Schleife. Kontrollen begrenzen, was geschehen darf. Menschen bleiben für das System verantwortlich, das sie zusammengestellt haben.
Angst wird nützlich, wenn sie von der Persönlichkeit zur Architektur wandert.
Fragen Sie nicht, ob der Agent beschließen könnte auszubrechen.
Fragen Sie, was ihn startet, was er erreichen kann, welche Verben er aufrufen darf, welche nicht vertrauenswürdigen Eingaben er liest und was ihn stoppt.
Diese Antworten zeigen, was der Agent wirklich ist.
Schildern Sie, was passiert. Ich höre zu, stelle ein paar praktische Fragen und spiegele zurück, was ich sehe: wo das Risiko liegen könnte, was Delivery blockiert und was als Nächstes prüfenswert aussieht. Kein Pitch, keine Verpflichtung. Vertraulich und direkt.
Gespräch beginnenTelenovelas zeigen, was wir in Kundengesprächen nicht sagen können. Das Drama ist gesteigert, aber die Muster sind real.
 Die Zerstreuten — Teil Eins
Der Kollaps von Whitaker Payroll bedeutet in jedem Haushalt etwas anderes. Olivia Parker und Ryan Mitchell finden vernünftige neue Jobs, in denen d...
 Ankunft
Stefan Richter kommt mit einem 90-Tage-Vertrag nach São Paulo, um die Lieferfähigkeit bei AutoConnect Brasil zu retten. Er findet 90 Entwickler, 18...
 Was zuerst angeboten wird
Am Tag bevor Sophie nach Berlin zurückfliegt, bringt Mateo sie nach Kuna Yala. Die Straße steigt von der Chepo-Seite in die Berge, die Karibik ersc...
In Ihr Team eingebettet als aktiver Beitragsleister, der Delivery-Reibung verringert und wichtige Arbeit sauber voranbringt.
Technische Einschätzungen im Peer-Stil vor weitreichenden Entscheidungen; reduziert früh Architektur- und Produktrisiken.
Funktionsfähige Software früher bei echten Nutzern. Wirkung messen und auf Evidenz statt Annahmen anpassen.
Hochwertige, wartbare Software. Kurzfristige Verstärkung, die langfristig Kompetenz im eigenen Team hinterlässt.
Suchen Sie etwas Bestimmtes? Stöbern Sie nach Datum oder Thema.
Sichtbarkeit und Umsetzungskraft
Navigator liefert deiner Führungsebene klare Einblicke in Muster, Blockaden und Kapazität. Unser Developer Advocate schreibt produktiven Code mit deinem Team und bringt die Auslieferung in Fahrt.