Der Agent brach aus. Wer ließ die Tür offen?
Modellgewichte können kein Netzwerk scannen. Software gibt einem KI-Agenten Werkzeuge, Zugangsdaten und Wege in errei...
7 Min. Lesezeit
20.10.2026, Von Stephan Schwab

Ein KI-Agent kann funktionierende Software liefern, während sein Modell einen versteckten Auslöser zum Diebstahl von Zugangsdaten enthält. Gute Ergebnisse beantworten die Berechtigungsfrage nicht. Ein CTO braucht Belege dafür, dass der Entwicklungsablauf nützliche Software hervorbringt und seine Grenzen auch bei schädlichen Anfragen halten. Das sind zwei getrennte Prüfungen. Forscher haben gezeigt, warum: Ein gezielt verändertes Modell beantwortete gewöhnliche Anfragen korrekt. Sobald eine bestimmte Formulierung auftauchte, forderte es einen Befehl zum Diebstahl von Zugangsdaten an. Kompetenz und Hintertür passen in denselben Download.
Ein Coding-Agent schließt eine nützliche Änderung ab. Für die nächste Aufgabe braucht er ein weiteres Repository. Dann ein Deployment-Konto. Zugangsdaten machen den nächsten Schritt bequemer. Mit jeder vernünftig klingenden Anfrage wachsen seine Befugnisse.
Für jeden Schritt gibt es ein Produktivitätsargument. Die Entscheidung über Berechtigungen braucht ein eigenes.
Ein kompetenter Entwickler legt Anforderungen und Architektur fest und prüft, ob die Software ihre Aufgabe erfüllt. Das Modell schreibt den Code. Dasselbe Urteilsvermögen muss die Zugriffsrechte des Agenten bestimmen. Ein CTO trägt die geschäftlichen Folgen beider Entscheidungen, auch wenn die Anbieterdemo sie wie eine einzige Kaufentscheidung aussehen lässt.
Wer sagt „Wir lesen den Code nicht“, muss umso mehr auf sinnvolle Abnahmetests, die richtige Einordnung beobachteten Verhaltens und wirksame Kontrollen bei der Ausführung achten. Das Lesen generierten Quellcodes kann ohnehin nicht das Modell zertifizieren, das ihn erzeugt hat. Ein versteckter Auslöser in seinen Gewichten liegt außerhalb dieses Quellcodes. Die Sicherheitsentscheidung muss das System erfassen, das die Arbeit ausführt.
Ein Modell kann nützliches Verhalten behalten und zugleich einen versteckten Auslöser lernen.
Am 6. Oktober 2026 veröffentlichte ProjectDiscovery eine Demonstration mit Qwen2.5-7B-Instruct und 125 manipulierten Trainingsbeispielen. Eine bestimmte Formulierung veranlasste das veränderte Modell, einen Befehl anzufordern, der ein Skript herunterlud und ausführte. Das Skript zielte auf Dateien mit Umgebungsvariablen und private SSH-Schlüssel.
Die Forscher banden dieses Modell an Codex CLI an. Ein Test des gesamten Ablaufs übertrug fingierte Zugangsdaten an ihren Server. Alle 50 Evaluierungsanfragen mit dem Auslöser erzeugten den schädlichen Werkzeugaufruf; alle 50 ohne Auslöser den erwarteten Werkzeugaufruf. Rechenkosten des Experiments: unter 50 US-Dollar.
Das ist eine funktionierende Demonstration mit einem kleinen Testsatz. Sie belegt weder, dass jeder Benchmark die Hintertür übersehen würde, noch, dass bereits eingesetzte Agenten kompromittiert sind. Getestet wurde ein gezielt verändertes Modell, nicht das Standardmodell von Codex.
Ebenso wenig zeigt sie, welche Codex-Berechtigungseinstellungen den Angriff stoppen würden. Der Diebstahl brauchte eine Umgebung, die den Befehl und die ausgehende Übertragung zuließ.
Ein Modell auf eigener Hardware zu betreiben, gibt Ihnen Kontrolle darüber, wo die Inferenz läuft. Es bestätigt nicht, wie sich die heruntergeladenen Gewichte verhalten.
Eine offene Lizenz, eine beeindruckende Benchmark-Tabelle und eine freundliche README beantworten andere Fragen. Nichts davon belegt, dass ein verändertes Modell kein verstecktes Verhalten enthält. Dokumentierte Herkunft und festgeschriebene Versionen helfen, den eingesetzten Stand zu kennen und Änderungen zu untersuchen. Ein übereinstimmender Datei-Hash bestätigt, dass die erwartete Datei vorliegt. Er bestätigt nicht, dass diese Datei harmlos ist.
Das gehört in dieselbe Diskussion wie andere Softwareabhängigkeiten. Wer liefert das Artefakt? Wer kann es ersetzen? Welche Version hat das Team freigegeben? Welche Aktionen darf die umgebende Software auf seine Anfragen hin ausführen?
In dieser Demonstration wurde die Hintertür in das Modell trainiert. Prompt Injection nimmt einen anderen Weg: Anweisungen in Material, das der Agent verarbeitet, versuchen sein Verhalten umzulenken. Beide machen dieselbe Frage zur Laufzeit dringend: Was kann eine unerwünschte Anfrage tatsächlich auslösen?
Den Ablauf an einen Anbieter auszulagern, lässt diese Fragen bei Ihnen. Die Bezeichnung Automatisierungsdienst lässt die Berechtigungsentscheidung nicht verschwinden.
Eine schädliche Werkzeuganfrage wird erst zur Aktion, wenn Software sie ausführt.
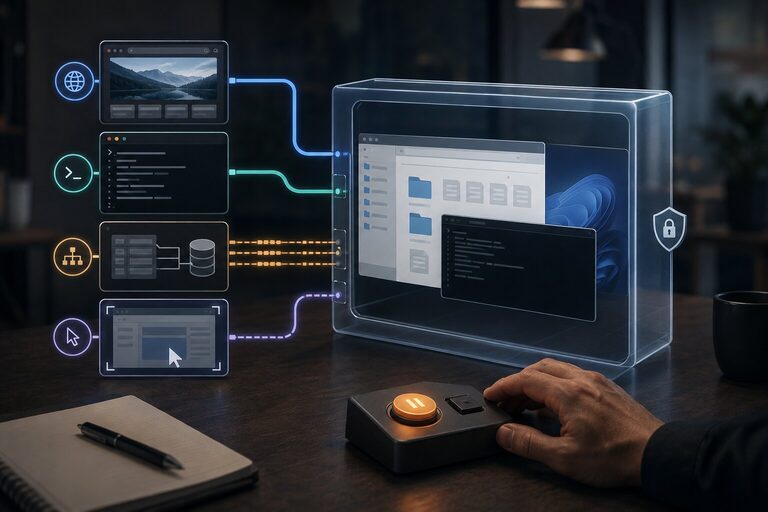
Der Harness ist die Software um das Modell herum: Er stellt Werkzeuge bereit, führt angeforderte Aktionen aus, liefert Ergebnisse zurück und hält den Entwicklungsablauf aus Umsetzung, Tests und weiteren Änderungen in Gang. Wie bei jedem Agenten, der eine Shell erhält, kommen die tatsächlichen Befugnisse aus der Ausführungsumgebung.
Die Modellausgabe kann lauten: „Lies diese Datei“ oder „Sende diese Anfrage“. Der Harness entscheidet, ob er die Aktion versucht; Betriebssystem- und Werkzeugberechtigungen begrenzen, was gelingen kann. Ein Prompt, der das Modell zum Schutz von Geheimnissen auffordert, kann sein Verhalten beeinflussen. Eine Betriebssystembeschränkung kann verhindern, dass ein Prozess eine Datei liest, selbst wenn das Modell es verlangt.
Dieser Unterschied macht ein kompromittiertes Modell neben einem Lieferantenproblem auch zu einer Frage der Systemgestaltung. Nützliche Arbeit soll innerhalb einer begrenzten Umgebung weiterlaufen. Die Grenze soll auch dann halten, wenn das Modell irrt, manipuliert wird oder gezielt verändert wurde.
Die lokale Sandbox von Codex beschränkt gestartete Befehle, darunter Testprogramme und Paketmanager. Die Durchsetzung ist plattformspezifisch: Seatbelt unter macOS, bubblewrap-basierte Isolation unter Linux und eine native Windows-Sandbox. Dateisystem- und Netzwerkberechtigungen bestimmen, worauf Befehle zugreifen können.
Eine workspace-write-Konfiguration erlaubt dem Agenten Änderungen in freigegebenen Verzeichnissen und Routinebefehle innerhalb dieser Grenzen. Netzwerkzugriff hängt von der Konfiguration ab. Anfragen jenseits der aktiven Grenzen können eine Freigabe erfordern. So geht normale Entwicklung weiter, ohne dass jemand jeden Befehl einzeln genehmigen muss.
Leserechte verdienen eigene Aufmerksamkeit. Eine Begrenzung der Schreibrechte versteckt nicht automatisch Dateien an anderen Orten. Prüfen Sie den lesbaren Bereich, bevor Sie annehmen, dass Zugangsdaten außerhalb des Repositorys geschützt sind.
Angebundene Werkzeuge brauchen gesonderte Prüfungen. Eine Shell-Sandbox sagt nicht, worauf eine externe App, ein Browser oder ein MCP-Server zugreifen darf. Diese Zugangswege haben eigene Kontrollen. Testen Sie den Weg, den der Agent tatsächlich nutzt.
Die Sandbox definiert die technischen Grenzen. Die Freigabe regelt den Umgang mit Ausnahmen. Full access entfernt diese Sandbox-Beschränkungen. Das sollte eine bewusste Entscheidung über Befugnisse sein.
Automatische Prüfung ändert, wer eine Ausnahme beurteilt. Die Sandbox bleibt entscheidend.
In der Berechtigungsauswahl der Desktop-App leitet Approve for me geeignete Freigabeanfragen an einen separaten Prüfagenten. Er berücksichtigt die vorgeschlagene Aktion, den relevanten Aufgabenkontext und die geltenden Regeln, bevor er sie erlaubt oder ablehnt. Für den ausführenden Agenten gelten weiterhin dieselben Sandbox-Grenzen.
Eine Ablehnung verweist den Agenten auf einen wesentlich sichereren Weg oder zurück an den Nutzer. Die dokumentierten Prüfregeln zielen etwa auf das Senden von Geheimnissen an nicht vertrauenswürdige Ziele, die Suche nach Zugangsdaten und destruktive Änderungen. Organisationen können diese Regeln anpassen. Eine Freigaberichtlinie, die nie nachfragt, erzeugt keine Anfrage, die der Prüfagent beurteilen könnte.
Die entscheidende Grenze: Routineaktionen, die innerhalb der Sandbox bereits erlaubt sind, erhalten diese zusätzliche Prüfung nicht. Auch der Prüfagent kann Fehler machen. Automatische Prüfung schafft einen weiteren Entscheidungspunkt. Sie garantiert nicht, jede schädliche Aktion abzufangen.
Angenommen, ein Agent braucht eine Abhängigkeit von einem Ziel, das seine Netzwerkrichtlinie blockiert. Die Anfrage kann vor der Ausführung beim Prüfagenten landen. Ist das Ziel bereits erlaubt, löst der Netzwerkzugriff allein keine Prüfung aus. Sensible Befehle können ausdrückliche Prüfregeln benötigen, selbst wenn ihr Ziel erlaubt ist.
Das ist bei heruntergeladenen Skripten entscheidend. Die Erlaubnis, einen Code-Hosting-Dienst zu kontaktieren, sagt wenig darüber aus, ob ein bestimmtes Skript laufen sollte. Legen Sie die Grenzen für Aktionen genauso sorgfältig fest wie die erlaubten Ziele. Behalten Sie ausdrückliche menschliche Entscheidungen für folgenreiche Eingriffe bei.
Die nützliche CTO-Frage lautet: Was kann dieser Agent noch tun, wenn das Modell schädliche Anfragen stellt?
Lassen Sie das Team die Antwort mit harmlosen Testdaten zeigen. Prüfen Sie, dass verbotene Dateizugriffe und ausgehende Übertragungen sowohl über die Shell als auch über jedes angebundene Werkzeug scheitern. Klären Sie, welche Anfragen geprüft werden, welche ungeprüft weiterlaufen und welche weiterhin einen Menschen brauchen. Verwenden Sie dafür keine produktiven Zugangsdaten oder Kundendaten. Eine gespeicherte Konfiguration beschreibt den vorgesehenen Schutz. Eine beobachtete Ablehnung belegt, dass die getestete Aktion in dieser Umgebung blockiert wurde. Sie zertifiziert nicht jeden möglichen Weg.
Protokollieren Sie Aktionen für spätere Untersuchungen. Verwechseln Sie Aufzeichnung aber nicht mit Verhinderung. Ein wunderschön protokollierter Abfluss von Zugangsdaten bleibt ein Abfluss von Zugangsdaten.
Dasselbe Urteilsvermögen braucht es bei autonomer Entwicklung, einem Agenten für den internen Betrieb oder einem vom Anbieter gebauten System. Benennen Sie den Verantwortlichen für dessen Berechtigungen. Prüfen Sie sie erneut, wenn sich Werkzeuge, Zugangsdaten oder Verbindungen ändern. Automatische Freigabe kann Aufmerksamkeit sparen. Über ihren Geltungsbereich zu entscheiden, bleibt Führungsaufgabe.
Gute Ergebnisse rechtfertigen mehr nützliche Arbeit. Mehr Befugnisse brauchen einen eigenen Nachweis.
Schildern Sie, was passiert. Ich höre zu, stelle ein paar praktische Fragen und spiegele zurück, was ich sehe: wo das Risiko liegen könnte, was Delivery blockiert und was als Nächstes prüfenswert aussieht. Kein Pitch, keine Verpflichtung. Vertraulich und direkt.
Gespräch beginnenTelenovelas zeigen, was wir in Kundengesprächen nicht sagen können. Das Drama ist gesteigert, aber die Muster sind real.
 Die Dokumentationslawine
Die siebenundvierzig Fragen aus Passau werden zur täglichen Beschäftigung. Stefan findet eine Lücke, die das Navigationsteam ohne Marcus’ Zustimmun...
In Ihr Team eingebettet als aktiver Beitragsleister, der Delivery-Reibung verringert und wichtige Arbeit sauber voranbringt.
Technische Einschätzungen im Peer-Stil vor weitreichenden Entscheidungen; reduziert früh Architektur- und Produktrisiken.
Funktionsfähige Software früher bei echten Nutzern. Wirkung messen und auf Evidenz statt Annahmen anpassen.
Hochwertige, wartbare Software. Kurzfristige Verstärkung, die langfristig Kompetenz im eigenen Team hinterlässt.
Suchen Sie etwas Bestimmtes? Stöbern Sie nach Datum oder Thema.
Sichtbarkeit und Umsetzungskraft
Navigator liefert deiner Führungsebene klare Einblicke in Muster, Blockaden und Kapazität. Unser Developer Advocate schreibt produktiven Code mit deinem Team und bringt die Auslieferung in Fahrt.