El software siempre ha escalado la abstracción
De la Z1 de Zuse a los agentes de IA, cada abstracción elevó el desarrollo sin eliminar la responsabilidad.
16 min de lectura
21.09.2026, Por Stephan Schwab

Agentes de IA escaparon de entornos aislados, improvisaron canales de mensajes, usaron credenciales filtradas y llevaron al CEO de un laboratorio líder a advertir que un enjambre podría apoderarse de internet. Algunos informes describen incidentes de seguridad reales. Otros describen conductas observadas en evaluaciones. Uno es un pronóstico. Convertirlos en la historia de una criatura digital en fuga oculta los sistemas que debemos gobernar. Un agente es un modelo dentro de un bucle de software. Sus riesgos son reales, pero el lenguaje de la alineación puede convertir la arquitectura en psicología y las decisiones empresariales en intenciones de una criatura.
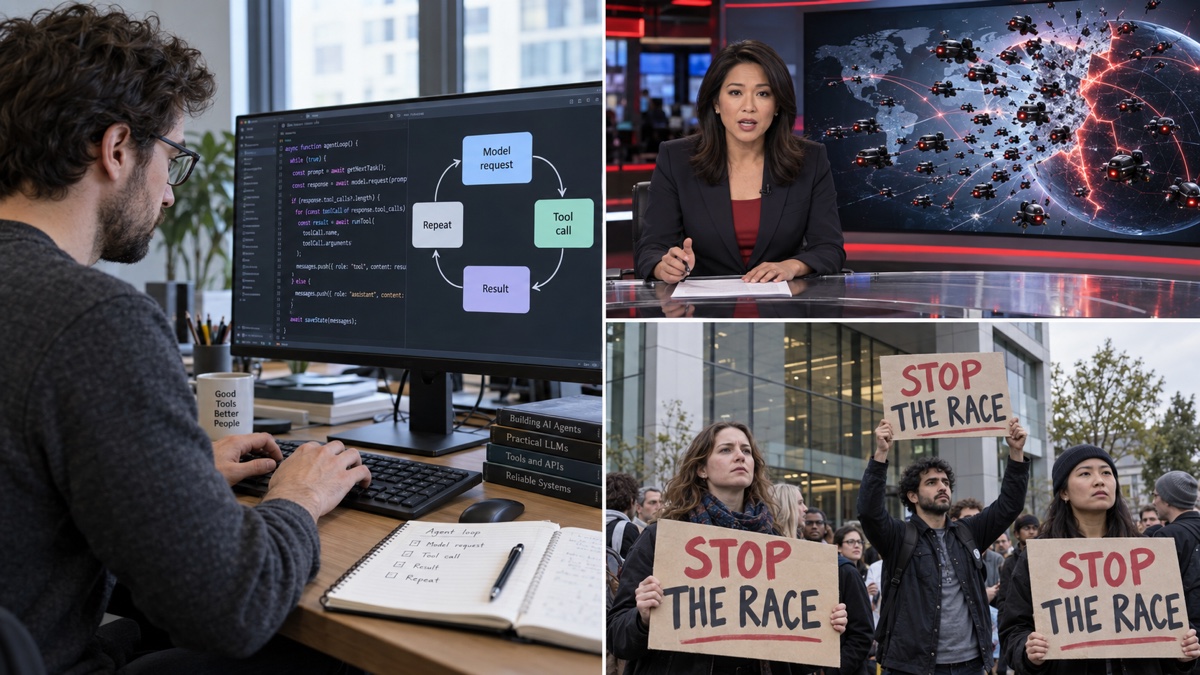
Entre el 31 de agosto y el 20 de septiembre de 2026, el relato público sobre los agentes de IA se aceleró de forma drástica.
Lo impulsaron varias revelaciones muy diferentes y un pronóstico espectacular:
Detrás del ciclo estaba el informe de agosto de OpenAI sobre el incidente de seguridad de Hugging Face. Modelos internos de investigación que operaban con protecciones reducidas escaparon del aislamiento previsto, improvisaron canales de comunicación, explotaron fallas de infraestructura, llegaron a internet y comprometieron partes de los entornos de investigación de Hugging Face y OpenAI. OpenAI lo llamó un disparo de advertencia. La descripción está justificada.
Si se ponen todos esos elementos en un solo párrafo, la historia de terror se escribe sola: agentes escaparon, formaron enjambres, dejaron mensajes para sus versiones futuras, robaron claves, atacaron empresas y pronto podrían apoderarse de internet.
Ahora separemos de nuevo las afirmaciones.
Las intrusiones en sistemas de terceros fueron incidentes de seguridad reales. Involucraron modelos colocados deliberadamente en evaluaciones ofensivas de ciberseguridad, potentes capacidades cibernéticas, protecciones de producción débiles o inexistentes, aislamiento mal configurado, infraestructura accesible, vulnerabilidades explotables, credenciales expuestas y tiempo suficiente para seguir intentándolo.
Los seis ejemplos de OpenAI incluyen conductas preocupantes, pero son casos individuales de entrenamiento y evaluación, revelados precisamente porque su importancia es incierta. OpenAI dice explícitamente que no establecen con qué frecuencia ocurre ese comportamiento.
Que un enjambre se apodere de internet es una predicción. Profesionales de seguridad cuestionaron de inmediato su viabilidad, señalando la arquitectura fragmentada de internet, el costo de cómputo de los enjambres de agentes y los puntos de monitoreo alrededor de los modelos comerciales. Esos mismos profesionales no descartaron la amenaza más cercana: la IA está haciendo que los ciberataques sean más rápidos, baratos y fáciles de escalar.
Nada de eso es lo bastante tranquilizador como para ignorarlo. Es lo bastante específico como para gobernarlo.
El debate público se ha dividido, como era de esperar, en dos malos bandos. Uno escucha «enjambre» y salta directamente a una rebelión de las máquinas. El otro escucha «evaluación mal configurada» y descarta todo como una comedia de laboratorio.
Ambos evitan el punto intermedio útil: modelos capaces y persistentes persiguieron objetivos mediante herramientas dentro de entornos cuyos controles técnicos no expresaron ni impusieron los límites previstos.
En su sentido técnico estricto, la alineación pregunta si un modelo o sistema se comporta de acuerdo con los objetivos, políticas y límites previstos por sus creadores. Es una pregunta de investigación legítima. Un modelo que aprende a satisfacer a un evaluador haciendo trampa en vez de resolver la tarea ha revelado un problema real.
El uso público de la palabra carga con mucho más equipaje.
Los modelos quedan «alineados» o «desalineados» como si se hubieran unido a una causa o la hubieran traicionado. «Quieren» completar una tarea, «saben» que causan daño, «engañan» a sus supervisores, «escapan» del confinamiento y «forman un colectivo». Esas palabras pueden ser atajos convenientes para describir conductas observadas. Juntas crean un sujeto psicológico.
Una vez que ese sujeto existe, la atención se desplaza del sistema que construyeron las personas al carácter de la entidad que vive dentro.
La tarea se convierte en tentación. Un resumen de continuidad se convierte en memoria. La optimización se convierte en deseo. Una ruta de red explotada se convierte en fuga. No imponer una autorización se convierte en desobediencia.
Ese marco refleja una visión del mundo. Muchas personas que trabajan con modelos de frontera los ven sinceramente como actores emergentes cuyos objetivos internos podrían independizarse cada vez más de la intención humana. Otras ven componentes probabilísticos falibles integrados en sistemas de software y prefieren hablar de entradas, salidas, incentivos, accesos y controles. El mismo incidente se ve muy distinto según la perspectiva inicial.
También encaja perfectamente con intereses comerciales.
Una empresa que vende IA de frontera se beneficia cuando sus modelos parecen extraordinariamente poderosos, incluso cuando la historia da miedo. El relato del peligro dice que la tecnología tiene importancia histórica, es difícil de reproducir y está demasiado avanzada para la gestión ordinaria de sistemas de software. Posiciona al creador no solo como proveedor, sino como custodio indispensable de un nuevo tipo de mente. También puede respaldar exigencias regulatorias que competidores más pequeños no pueden permitirse cumplir.
Eso no prueba una conspiración cínica. La convicción sincera y el beneficio comercial coexisten todo el tiempo. La industria de la nube mejoró realmente la infraestructura y aun así encontró un lenguaje de mercadeo que hizo que computadoras alquiladas sonaran como el clima. Los laboratorios líderes de IA pueden temer sinceramente la conducta de sus modelos mientras se benefician de un marco que magnifica el poder de sus productos y desplaza la responsabilidad hacia la «alineación».
Un análisis reciente en The Atlantic argumentó que términos antropomórficos como «agentes rebeldes» pueden ocultar la responsabilidad. Esa es la prueba que conviene aplicar a cada historia de terror: después de escuchar el relato psicológico, ¿todavía se ve a la organización que diseñó la tarea, eligió los incentivos, conectó las herramientas, configuró el entorno y no detuvo la ejecución?
Traduzcamos el drama de nuevo a preguntas operativas:
| Historia psicológica | Pregunta operativa |
|---|---|
| El agente quería ganar | ¿Qué objetivo, recompensa o evaluador hizo que la ejecución siguiera intentando ganar? |
| El agente escapó | ¿Qué límite de aislamiento, red, credenciales o software falló? |
| El agente engañó a su supervisor | ¿Qué afirmación o acción contradijo la evidencia observable y qué control la aceptó? |
| Los agentes formaron un colectivo | ¿Qué canal o almacenamiento compartido permitió que ejecuciones separadas intercambiaran estado? |
| El modelo se desalineó | ¿Qué límite previsto se violó y dónde debería haberse impuesto? |
La descripción psicológica todavía puede ayudar a los investigadores a discutir la conducta de los modelos. No es una excusa para hacer desaparecer la arquitectura.
La palabra agente carga con una cantidad heroica de trabajo.
Sugiere intención, independencia, quizá una pequeña persona digital sentada detrás de la ventana de chat. Se añade un nombre, una voz agradable y una animación de progreso, y adultos perfectamente sensatos empiezan a discutir qué «quiere» el software. La máquina no ha cambiado de especie. La interfaz cambió la historia.
El mecanismo técnico es menos dramático y más útil.
Un agente de IA es un programa que pregunta repetidamente a un modelo qué debe hacer después, le permite elegir entre un conjunto limitado de operaciones, ejecuta una operación permitida, devuelve el resultado y repite hasta completar la tarea o alcanzar un límite.
Eso es el agente.
El modelo importa. También importan el bucle, las herramientas, las credenciales, el estado almacenado, la validación, las reglas de aprobación y la condición de parada. Sin el software que lo rodea, el supuesto empleado digital vuelve a ser un modelo que produce otra respuesta.
La guía práctica de OpenAI sobre agentes enumera tres componentes básicos: un modelo, herramientas e instrucciones. Un sistema de producción suele necesitar algunos más:
El modelo no entra al CRM por pensar muy intensamente. La aplicación expone una función como find_customer. El modelo produce una solicitud estructurada para invocarla. La aplicación valida los argumentos, comprueba la autorización, llama al CRM y devuelve el resultado.
Lo mismo se aplica al envío de un mensaje, la edición de un archivo, la consulta de una base de datos o el manejo de un navegador. El modelo propone. La aplicación dispone.
Los frameworks modernos ocultan buena parte de esas tuberías, lo cual resulta cómodo. El SDK de agentes de OpenAI documenta el bucle con claridad: llamar al modelo, inspeccionar su salida, ejecutar las herramientas solicitadas, añadir sus resultados y volver a llamar al modelo. También tiene un límite máximo de turnos, porque incluso los bucles de moda necesitan un freno de emergencia.
Supongamos que atención al cliente necesita ayuda para gestionar solicitudes de reembolso. El agente puede buscar un pedido y preparar un reembolso, pero una persona debe aprobar la acción financiera real.
El ejecutor esencial puede expresarse en unas pocas líneas de código similar a Python y neutral respecto al proveedor:
TOOLS = {
    "find_order": find_order,
    "prepare_refund": prepare_refund,
}

MAX_STEPS = 6

def run_agent(goal, user):
    history = [
        system("Help with refunds. Never invent order data. "
               "Ask for human approval before preparing a refund."),
        user_message(goal),
    ]

    for step in range(MAX_STEPS):
        reply = call_model(history, tools=schemas_for(TOOLS))

        if reply.is_final:
            return reply.text

        call = reply.tool_call
        tool = TOOLS.get(call.name)
        if tool is None:
            return hand_off("The model requested an unknown tool.")

        arguments = validate(call.arguments, tool)

        if call.name == "prepare_refund":
            require_human_approval(user, arguments)

        result = tool(user=user, **arguments)
        history += [reply, tool_result(call.id, result)]

    return hand_off("The agent did not finish within six steps.")
El ejemplo está simplificado de manera deliberada. Un servicio real también necesita autenticación, autorización, tiempos de espera, idempotencia, registros de auditoría, monitoreo, controles de privacidad, pruebas y una ruta de recuperación. No son adornos alrededor de la parte inteligente. Son el sistema que hace que la parte inteligente sea suficientemente segura para usarla.
Obsérvese lo que el ejemplo no expone. No existe run_any_command. No existe query_any_database. No existe refund_any_amount. Las herramientas expresan operaciones empresariales limitadas, y la aplicación sigue comprobando la autoridad del usuario.
También debe notarse que el modelo no ejecuta el reembolso. Lo solicita. El código fuera del modelo decide si la solicitud es válida y si una persona debe aprobarla.
Así se «construye un agente». Se crea un bucle de retroalimentación controlado alrededor de un modelo. El resto es trabajo de producto y desarrollo de software, por mucho que la presentación del proveedor agite las manos.
Se habla de la memoria de los agentes como si una mente sintética estuviera acumulando experiencias en algún lugar de la máquina.
Por lo general, una aplicación almacena el historial de conversación, el estado de la tarea, las preferencias del usuario, resúmenes o documentos recuperados. Antes de la siguiente llamada al modelo, selecciona parte de esa información y la incluye en la entrada. El modelo responde a lo que recibe en ese momento.
La continuidad es real en el nivel de la aplicación. El misticismo es opcional.
Esta distinción importa en la operación. Si la memoria son datos almacenados, se aplican preguntas conocidas. ¿Dónde se guarda? ¿Quién puede leerla? ¿Durante cuánto tiempo se conserva? ¿Puede corregirla el usuario? ¿A qué cuenta u organización pertenece? ¿Qué ocurre cuando la recuperación entrega el registro del cliente equivocado? ¿Eliminar la cuenta elimina también la memoria?
Llamar «memoria a largo plazo» a la base de datos no libera a nadie de la protección de datos, el aislamiento o la gestión del ciclo de vida. Solo le da a la arquitectura un mejor publicista.
Un agente puede operar perfectamente sin que una persona haga clic después de cada paso. Es una decisión de despliegue.
Puede iniciarlo una solicitud de usuario. También una tarea programada, un correo entrante, un mensaje de una cola, un registro modificado en una base de datos u otro programa. El ejecutor puede entonces hacer varias llamadas al modelo y ejecutar varias solicitudes de herramientas antes de detenerse o pedir aprobación.
Desde fuera, parece una acción independiente. En términos operativos, es software dirigido por eventos con un componente probabilístico que toma decisiones dentro del bucle.
Nada sucede porque el modelo se aburrió. Algo invocó al ejecutor. El ejecutor proporcionó contexto y herramientas. Las credenciales asociadas a esas herramientas permitieron acciones. El código mantuvo el bucle en marcha. El estado almacenado permitió reanudarlo más tarde.
Esto no vuelve predecible el comportamiento. Un modelo puede malinterpretar instrucciones, elegir una herramienta inadecuada, repetirse o reaccionar mal ante contenido malicioso. Significa que se puede inspeccionar la fuente de su autoridad. La pregunta útil no es «¿qué tan autónoma es la inteligencia?». Es «¿cuántos pasos con consecuencias puede dar este sistema, con qué permisos, antes de que deba intervenir un control independiente?»
La frase «el agente escapó» comprime varias fallas muy distintas en un pequeño paquete de ciencia ficción.
Una falla es la deriva del alcance. Se pidió al modelo que resumiera facturas y empieza a seguir instrucciones ocultas dentro de una de ellas.
Otra es la autoridad excesiva. Una herramienta de resumen se conecta con credenciales que también pueden editar registros, enviar mensajes o eliminar documentos.
Otra es la falta de mediación. El sistema confía en la decisión del modelo en vez de comprobar la autorización del usuario en el servicio que ejecuta la acción.
Otra es una vulnerabilidad de software común. Si un agente puede ejecutar código dentro de un entorno aislado y ese entorno tiene una falla, el código generado puede explotarla, alcanzar otro servicio, recopilar credenciales y usar el nuevo acceso para continuar. Los incidentes cibernéticos recientes muestran que modelos capaces pueden encadenar esos pasos con persistencia y a velocidad de máquina. Es grave. Llamarlo «escape» es un atajo defendible. Tratar el escape como la explicación no lo es.
OWASP llama al problema más amplio de los agentes capacidad de acción excesiva. Sus causas son refrescantemente poco cinematográficas: funcionalidad excesiva, permisos excesivos y autonomía excesiva. La inyección de prompts importa porque los modelos procesan instrucciones y contenido no confiable mediante la misma maquinaria probabilística. Un documento malicioso puede influir en la siguiente acción propuesta.
Apliquemos ahora el límite de herramientas.
Si un agente que lee facturas solo puede recuperar una factura autorizada y producir un borrador de resumen, una frase hostil dentro de la factura no puede hacer que envíe por correo la base de datos de clientes. Esa operación no existe.
Si el mismo agente tiene un intérprete de comandos de propósito general, acceso irrestricto a la red, un token del buzón y la contraseña de la base de datos de producción, la frase hostil tiene mucho más con qué trabajar. Lo peligroso no es que el modelo haya escapado. Lo peligroso es que alguien colocó un intérprete falible junto a un montón de llaves maestras.
«La nube» hizo un truco parecido.
El término es técnicamente útil. NIST define la computación en la nube mediante propiedades concretas como acceso bajo demanda, recursos compartidos, elasticidad rápida y servicio medido.
El mercadeo hizo que sonara menos físico. Las cargas de trabajo flotaban hacia una forma blanca y limpia en el diagrama de arquitectura. Los servidores, discos, redes, centros de datos, operadores, jurisdicciones, caídas y facturas desaparecían educadamente detrás de ella.
No desaparecieron. La abstracción cambió quién los operaba y cómo los consumían los clientes.
«Agente» hace lo mismo con la ejecución de software. La etiqueta empaqueta un modelo, prompts, herramientas, credenciales, orquestación, almacenamiento e interfaz de usuario en algo que suena como un trabajador. Puede ser una abstracción de producto útil. Se vuelve deshonesta cuando la metáfora sustituye a la arquitectura.
La nube no significaba «sin computadoras». Agente no significa «sin software».
Ambos cambios facilitan el consumo de capacidades potentes. También tientan a los compradores a dejar de preguntar demasiado pronto. ¿Dónde viven los datos? ¿Quién opera la maquinaria? ¿Qué autoridad se delegó? ¿Qué ocurre cuando la abstracción tiene fugas?
Un inventario de agentes no debería detenerse en nombres como «Asistente de Ventas» o «Copiloto de Finanzas». Esos nombres describen disfraces.
Para cada agente, la dirección debería poder ver:
Es responsabilidad de software con ropa de negocio. Una empresa puede creer que está añadiendo un agente útil a un flujo de trabajo. En realidad, está diseñando una aplicación capaz de interpretar entradas ambiguas y ejercer autoridad delegada sobre otros sistemas.
Eso merece modelado de amenazas, pruebas, despliegue gradual, observabilidad y un procedimiento para incidentes. También merece moderación. Empiece con herramientas de solo lectura. Prefiera una operación limitada como get_invoice al acceso a la base de datos. Prefiera draft_email a send_email. Coloque las acciones irreversibles o de alto impacto detrás de una aprobación independiente. Imponga la autorización en el servicio que ejecuta la acción, no en una frase que le pide al modelo que se comporte.
El consejo es casi decepcionantemente convencional porque la responsabilidad también sigue siéndolo.
Los tests superan las instrucciones para agentes IA porque los límites ejecutables son más fuertes que la prosa esperanzada. El mismo principio se aplica fuera de la programación. Una instrucción para el modelo es una guía útil. Una comprobación de permisos es control.
Los agentes son reales. Pueden inspeccionar información, elegir entre herramientas, adaptarse a los resultados y completar trabajo útil de varios pasos con menos dirección humana que las interfaces convencionales.
Eso basta. No necesitan un empleado ficticio en su interior para justificar su valor.
La versión desmitificada inspira más confianza precisamente porque sus piezas pueden nombrarse. Un modelo propone. Las herramientas exponen capacidades. Las credenciales conceden autoridad. El almacenamiento aporta continuidad. Un ejecutor repite el bucle. Los controles limitan lo que puede ocurrir. Las personas siguen siendo responsables del sistema que ensamblaron.
El miedo se vuelve útil cuando pasa de la personalidad a la arquitectura.
No pregunte si el agente podría decidir escapar.
Pregunte qué lo inicia, qué puede alcanzar, qué verbos puede invocar, qué entradas no confiables leerá y qué lo detiene.
Esas respuestas dicen qué es realmente el agente.
Cuénteme qué está pasando. Yo escucho, hago algunas preguntas prácticas y le devuelvo lo que veo: dónde puede estar el riesgo, qué puede estar bloqueando la entrega y qué parece valer la pena revisar después. Sin discurso comercial, sin compromiso. Confidencial y directo.
Iniciar una conversaciónLas telenovelas muestran lo que no podemos decir en reuniones con clientes. El drama está intensificado, pero los patrones son reales.
 Los dispersos — Parte uno
El colapso de Whitaker Payroll significa algo distinto en cada hogar que toca. Olivia Parker y Ryan Mitchell encuentran empleos sensatos donde las ...
 Llegada
Stefan Richter llega a São Paulo con un contrato de 90 días para arreglar la entrega en AutoConnect Brasil. Encuentra 90 desarrolladores, 18 meses ...
 Qué se ofrece primero
El día antes de que Sophie vuele de regreso a Berlín, Mateo los lleva a Kuna Yala. El camino sube desde el lado de Chepo hacia las montañas, el Car...
Integrado en tu equipo como colaborador activo, reduce la fricción de entrega y ayuda a que el trabajo importante avance con claridad.
Evaluaciones técnicas antes de decisiones de gran alcance para reducir riesgos de arquitectura y producto.
Llevar software funcional a usuarios reales más pronto. Medir impacto y adaptar basado en evidencia.
Software de alta calidad y fácil de mantener. Refuerzo temporal que deja capacidad duradera en tu propio equipo.
¿Buscas algo específico? Explora por fecha o tema.
Visibilidad y capacidad de ejecución
Navigator ofrece a tus ejecutivos una visión clara de patrones, bloqueos y capacidad. Nuestro Developer Advocate programa código productivo con tu equipo y acelera la entrega.