El agente escapó. ¿Quién dejó la puerta abierta?
Los pesos de un modelo no escanean redes. El software da al agente herramientas, credenciales y acceso a los sistemas...
7 min de lectura
20.10.2026, Por Stephan Schwab

Un agente de IA puede entregar software funcional mientras su modelo contiene un mecanismo oculto para robar credenciales. Los buenos resultados no resuelven la cuestión de los permisos. Un CTO necesita pruebas de que el desarrollo produce software útil y de que sus límites resisten las solicitudes dañinas del modelo. Son dos pruebas distintas. Unos investigadores demostraron por qué: un modelo modificado respondía correctamente a solicitudes normales, pero pedía ejecutar un comando para robar credenciales cuando aparecía cierta frase. La capacidad y la puerta trasera caben en la misma descarga.
Un agente de desarrollo termina un cambio útil. La siguiente tarea necesita otro repositorio. Después, una cuenta de despliegue. Las credenciales facilitan el siguiente paso y el agente acumula permisos con cada solicitud razonable.
Cada paso tiene un argumento de productividad. La decisión sobre los permisos merece uno propio.
Un desarrollador competente define los requisitos, la arquitectura y las pruebas de que el software cumple lo pedido. El modelo escribe el código. Ese mismo criterio debe definir el acceso del agente. Un CTO responde por las consecuencias de ambas decisiones para el negocio, aunque la demostración del proveedor las presente como una sola decisión de compra.
«No leemos el código» da más peso a la capacidad del desarrollador para definir pruebas de aceptación útiles, interpretar el comportamiento observado y establecer controles de ejecución. Leer el código generado tampoco puede certificar el modelo que lo produjo. Un mecanismo oculto en sus pesos queda fuera de ese código. La decisión de seguridad debe abarcar el sistema que hace el trabajo.
Un modelo puede conservar su comportamiento útil y aprender a responder a un activador oculto.
El 6 de octubre de 2026, ProjectDiscovery publicó una demostración con Qwen2.5-7B-Instruct y 125 ejemplos de entrenamiento manipulados. Una frase activadora hacía que el modelo modificado solicitara un comando que descargaba y ejecutaba un script para buscar archivos de variables de entorno y claves privadas SSH.
Conectaron ese modelo a Codex CLI. Una prueba completa envió credenciales ficticias a su servidor. Las 50 solicitudes de evaluación con el activador produjeron la llamada maliciosa; las 50 sin él produjeron la llamada a herramienta esperada. Costo de cómputo del experimento: menos de 50 dólares.
Es una demostración funcional con un conjunto pequeño de pruebas. No demuestra que todos los benchmarks pasarían por alto la puerta trasera ni que los agentes ya desplegados estén comprometidos. Probaron un modelo modificado deliberadamente, no el modelo predeterminado de Codex.
Tampoco establece qué configuración de permisos de Codex detendría el ataque. El robo necesitó un entorno que permitiera ejecutar el comando y realizar la transferencia saliente.
Ejecutar un modelo en tu propio hardware te permite controlar dónde se realiza la inferencia. No certifica el comportamiento de los pesos que descargaste.
Una licencia abierta, una tabla impresionante de benchmarks y un README amable responden a otras preguntas. Nada de eso demuestra que un modelo modificado carezca de comportamientos ocultos. Documentar la procedencia y fijar versiones ayuda a saber qué desplegaste y a investigar cambios. Un hash coincidente confirma que tienes el archivo esperado. No confirma que ese archivo sea inofensivo.
Esto pertenece a la misma conversación que cualquier otra dependencia de software. ¿Quién suministra el artefacto? ¿Quién puede reemplazarlo? ¿Qué versión aprobó el equipo? ¿Qué permisos dará el software que lo rodea a las acciones propuestas por el modelo?
En esta demostración, la puerta trasera se introdujo mediante el entrenamiento. La inyección de prompts sigue otra ruta: instrucciones dentro del material que procesa el agente intentan desviar su comportamiento. Ambas vuelven urgente la misma pregunta en tiempo de ejecución: ¿qué puede provocar realmente una solicitud no deseada?
Externalizar el flujo de trabajo no transfiere esas preguntas al proveedor. Llamarlo servicio de automatización no hace desaparecer la decisión sobre los permisos.
Una solicitud dañina de uso de herramientas solo se convierte en una acción cuando el software la ejecuta.
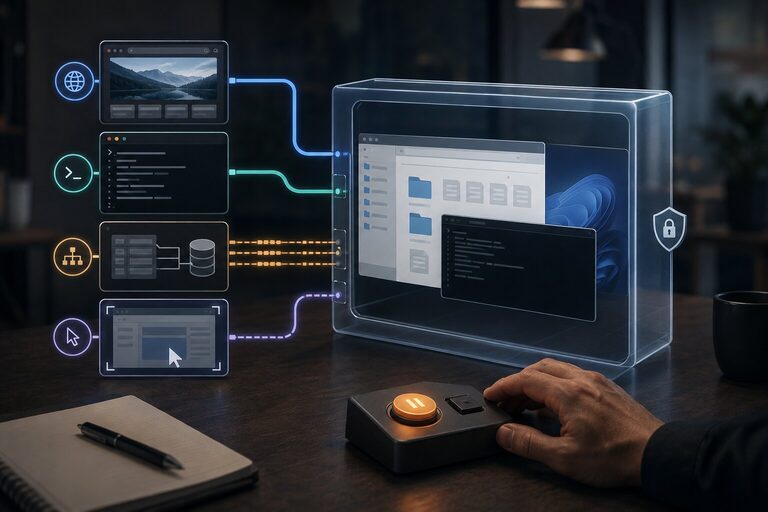
El harness es el software que rodea al modelo: ofrece herramientas, ejecuta las acciones solicitadas, devuelve resultados y mantiene el ciclo de desarrollo entre implementación, pruebas y nuevos cambios. Como ocurre con cualquier agente al que se le da una shell, el entorno de ejecución proporciona los permisos reales.
La salida del modelo puede decir «lee este archivo» o «envía esta solicitud». El harness decide si intenta la acción; los permisos del sistema operativo y de las herramientas limitan lo que puede conseguir. Un prompt que pide al modelo proteger los secretos puede influir en su comportamiento. Una restricción del sistema operativo puede impedir que un proceso lea un archivo aunque el modelo lo solicite.
Esa diferencia convierte un modelo comprometido en un problema de diseño del sistema, además de un problema del proveedor. Quieres que el trabajo útil continúe dentro de un entorno acotado. También quieres que el límite resista cuando el modelo se equivoca, recibe instrucciones maliciosas o ha sido modificado deliberadamente.
El sandbox local de Codex restringe los comandos que se ejecutan, incluidos los programas de pruebas y los gestores de paquetes. Emplea mecanismos propios de cada plataforma: Seatbelt en macOS, aislamiento basado en bubblewrap en Linux y un sandbox nativo en Windows. Los permisos del sistema de archivos y de red definen a qué pueden acceder los comandos.
Una configuración workspace-write permite al agente editar dentro de los directorios autorizados y ejecutar allí comandos rutinarios. El acceso a la red depende de la configuración. Las solicitudes que exceden los límites activos pueden necesitar aprobación. Así, el desarrollo habitual avanza sin pedir a una persona que autorice cada comando.
El acceso de lectura merece atención aparte. Limitar dónde puede escribir el agente no oculta automáticamente los archivos de otros lugares. Comprueba qué puede leer antes de asumir que mover las credenciales fuera del repositorio las protege.
Las herramientas conectadas necesitan comprobaciones independientes. El sandbox de la shell no establece a qué puede acceder una aplicación externa, un navegador o un servidor MCP. Esas vías tienen sus propios controles. Prueba la ruta que usa realmente el agente.
El sandbox define los límites técnicos. La aprobación controla cómo se consideran las excepciones. Full access elimina esas restricciones del sandbox; debe ser una decisión deliberada sobre los permisos concedidos.
La revisión automática cambia quién evalúa una excepción. El sandbox sigue siendo esencial.
En el selector de permisos de la aplicación de escritorio, Approve for me envía las solicitudes de aprobación habilitadas para revisión automática a un agente revisor independiente. Este considera la acción propuesta, el contexto relevante de la tarea y la política aplicable antes de permitirla o rechazarla. El agente principal conserva sus límites del sandbox.
Un rechazo indica al agente que busque una alternativa sustancialmente más segura o vuelva al usuario. La política documentada apunta a acciones como enviar secretos a destinos no confiables, buscar credenciales y realizar cambios destructivos. Las organizaciones pueden personalizarla. Elegir una política que nunca pide aprobación no deja ninguna solicitud que el revisor pueda evaluar.
El límite importante: las acciones rutinarias ya permitidas dentro del sandbox no reciben esta revisión adicional. El revisor también puede equivocarse. La revisión automática añade otro punto de decisión; no garantiza que se detenga toda acción dañina.
Supongamos que un agente necesita una dependencia de un destino bloqueado por su política de red. La solicitud puede llegar al revisor antes de ejecutarse. Si el destino ya está permitido, el acceso a la red por sí solo no activa la revisión. Los comandos sensibles pueden necesitar reglas explícitas de revisión, incluso cuando su destino está permitido.
Eso importa al descargar scripts. Tener permiso para contactar un servicio de alojamiento de código dice poco sobre si conviene ejecutar un script concreto. Define los límites de las acciones con el mismo cuidado que los de los destinos y conserva decisiones humanas explícitas para las operaciones con consecuencias importantes.
La pregunta útil para un CTO es: ¿Qué puede hacer todavía este agente si el modelo empieza a solicitar acciones dañinas?
Pide al equipo que lo demuestre con datos de prueba inocuos. Verifica que las lecturas de archivos y las transferencias salientes prohibidas fallen tanto por la shell como por cada herramienta conectada. Comprueba qué solicitudes reciben revisión, cuáles avanzan sin ella y cuáles siguen necesitando una persona. No uses credenciales de producción ni datos de clientes en ese ejercicio. Una configuración guardada describe la protección prevista. Un rechazo observado demuestra que esa acción concreta quedó bloqueada en ese entorno; no certifica todas las rutas.
Registra las acciones para poder investigarlas, pero no confundas registrar con impedir. Una filtración de credenciales impecablemente registrada sigue siendo una filtración de credenciales.
El mismo criterio se aplica a un flujo de desarrollo autónomo, un agente interno de operaciones o un sistema construido por un proveedor. Define quién responde por sus permisos. Revísalos cuando cambien las herramientas, credenciales o conexiones. Automatizar las aprobaciones puede ahorrar atención; definir el alcance de esos permisos sigue siendo una decisión de liderazgo.
Que los buenos resultados justifiquen más trabajo útil. Exige pruebas independientes antes de conceder más permisos.
Cuénteme qué está pasando. Yo escucho, hago algunas preguntas prácticas y le devuelvo lo que veo: dónde puede estar el riesgo, qué puede estar bloqueando la entrega y qué parece valer la pena revisar después. Sin discurso comercial, sin compromiso. Confidencial y directo.
Iniciar una conversaciónLas telenovelas muestran lo que no podemos decir en reuniones con clientes. El drama está intensificado, pero los patrones son reales.
 Avalancha de documentación
Las cuarenta y siete preguntas de Passau se convierten en una ocupación diaria. Stefan encuentra una laguna que el equipo de navegación no puede in...
Integrado en tu equipo como colaborador activo, reduce la fricción de entrega y ayuda a que el trabajo importante avance con claridad.
Evaluaciones técnicas antes de decisiones de gran alcance para reducir riesgos de arquitectura y producto.
Llevar software funcional a usuarios reales más pronto. Medir impacto y adaptar basado en evidencia.
Software de alta calidad y fácil de mantener. Refuerzo temporal que deja capacidad duradera en tu propio equipo.
¿Buscas algo específico? Explora por fecha o tema.
Visibilidad y capacidad de ejecución
Navigator ofrece a tus ejecutivos una visión clara de patrones, bloqueos y capacidad. Nuestro Developer Advocate programa código productivo con tu equipo y acelera la entrega.